
先明确目标:从侧面挖出一个洞
我们希望玩家能从岩壁侧面挖进去,同时保留洞顶和洞底。因此,系统需要知道山体内部哪里有土石,哪里是空气。
只记录一层地表高度
同一个位置只描述一个高度,无法单独表示洞顶与洞底。
记录山体内部的实与空
内部也有记录,因此可以在土石中保留一段空气。
这里的“体素地形”,指的就是用空间中的数据描述地形体积。下一步先看这些数据具体记录什么。
下一步:内部如何记录 →每个采样位置,记录有多少土石
把空间划成有规律的采样格。每个位置记录一个占据量:接近“实”表示有土石,接近“空”表示空气;中间值帮助确定边界的位置。材料类别另行记录它属于哪种土石。
采样是内容
数据块是管理分组
采样点不是画面里的小方块。“数据块”也只是存储分组。分块后,挖掘可以只修改附近的数据,而不必复制整座山。
下一步:数据怎样变成表面 →从实与空的交界,生成可见表面
有了内部数据,系统再寻找从“实”变成“空”的位置。将这些位置连接成三角形,就得到用于显示的网格。表面可以落在采样点之间,所以画面不必呈现为一堆立方体。
同一份内部数据
找到边界后生成表面
- 地形数据
- 记录内部的实、空和材料。
- 表面网格
- 从数据生成,负责画面显示。
- 碰撞几何
- 供角色接触、射线等查询使用。
一次挖掘,沿这条链传递
挖掘首先修改的是数据。洞口的画面和碰撞,都是这次修改的后续结果。
- 01改数据
把笔刷范围内的部分土石改为空气。
- 02找受影响块
复制并写入变化块,其他块继续共享。
- 03生成新网格
从修改后的实、空边界生成新表面。
- 04准备新碰撞
从新表面建立新的三角形碰撞。
- 05切换资源
让新网格与新碰撞接管显示和查询。
新资源准备好之前,旧表面和旧碰撞先保留。这样玩家不必等待所有计算完成,也不会因为新碰撞尚未生成就突然失去脚下的地面。
下面用同一份三维数据逐步执行这条链。先观察完整山体,再提交一次挖掘。
下一步:在三维中逐步观察 →把这条更新链,放到三维中观察
先拖动视图看看完整山体,再点击“提交挖掘”。之后每推进一个阶段,都对应上面更新链的一步。V0 表示本轮编辑前的版本,V1 表示第一次编辑后的版本。
- 01 编辑前
- 02 改内部数据
- 03 生成新表面
- 04 准备新碰撞
- 05 切换完成
- 世界数据
- V0
- 已发布网格
- V0
- 当前碰撞
- V0
- 本轮修改
- 0 采样 / 0 块
可以在新洞壁上再次点击并提交挖掘,继续向内延伸。这是实际计算数据、网格和三角形命中的浏览器教学模型:它用小场景全量生成网格,编辑采用球形空腔合并,不执行 UE 的材料工作量、自定义过滤、LOD、线程任务或 Chaos 烹饪。剖切仅影响显示;距离不是耗时。刷新页面恢复初始场景。
现在可以区分三件事:数据描述内部,网格显示表面,碰撞负责接触查询。三者来自同一份地形状态,但完成更新的时刻不同。
继续阅读:这条更新链的性能开销 →这条更新链,消耗多少资源
下面是 UE 地图的实际采样,与上方浏览器教学演示分开。先看一次修改在哪里花时间,再看整帧与内存;未单独测量的部分直接保留为空缺。
i9-14900KF / RTX 5070 12 GB / 64 GB。Development Editor -game、D3D12 SM5、100% 渲染比例,四阶段各 30 秒,阶段首尾各去除 0.5 秒。未检测到其他游戏进程;采用离屏产帧,不能当作屏幕呈现 FPS。
小 / 大笔刷在固定中心交替挖填,间隔分别为 0.34 / 0.12 秒。本轮没有 Lumen、水体求解、烟雾、正式植被、AI 和完整角色负载。
静止观察:有效帧 15,105,接受编辑 0 次,更新组稳定 0 次。两者按各自记录时刻归档,跨阶段完成的组可能使数量不同。下图分别统计真实发生工作的样本,不用空闲帧稀释开销。
条长以 8.333 ms 为参照。四条的统计单位不同,不能相加;安装软预算 0.35 ms 是限流参数,不是耗时保证。
逐步查看 CPU、GPU 和内存归属
| 步骤 | CPU 计时与范围 | GPU 工作 | 内存 / 显存 |
|---|---|---|---|
| 01 命中与笔刷定位 | 未单独测量;本轮使用固定中心直接编辑。 | CPU 查询;无独立地形计算 Pass。 | 未做该步骤分配追踪。 |
| 02 修改数据与更新父层 | 本阶段没有编辑。 | CPU 执行;不向 GPU 写整个体素世界。 | 本轮对齐编辑数组:—;压缩节点、COW 和容器开销另计。 |
| 03 失效、LOD 与排队 | 与地形 Tick、安装及发布存在包含关系;未独立隔离。 | CPU 调度;后续渲染更新另计。 | 节点状态、通知、在途快照;独立增量未测。 |
| 04 读取 / 过滤 / 网格 / 打包 | 没有按编辑组记录任务耗时。 | 本地图走 CPU 网格生成;没有对应 GPU 计算 Pass。 | 单个 Level 6 任务固定数组约 632.94 KiB;几何输出另加。 |
| 05 UE Section 预整理 | 位于后台 PrepareUploadMesh;不在 MeshNode 计时内,未单测。 | CPU 建立上传结构;GPU 资源随后创建。 | 还会建立 FProcMeshSection 顶点 / 索引副本,未独立采样。 |
| 06 安装与碰撞提交 | 未单独测量 / 活动帧 | GPU 资源创建与传输未独立计时;不能记为 0。 | 旧资源、新 Section 和在途渲染资源可能同时存在。 |
| 07 Chaos 碰撞烹饪 | 异步执行;独立 CPU 工作时间尚未测量。 | 该路径为 CPU 碰撞;不使用 GPU 流体或粒子碰撞。 | 三角形碰撞与加速结构尚未单独归属。 |
| 08 节点发布与旧资源回收 | 未单独测量 / 活动帧 | 渲染状态切换 / 延迟释放未独立归属。 | 共享引用与旧资源释放时机决定峰值;本轮未分配追踪。 |
| 09 持续显示新地形 | 整场景 Game Thread P95 1.241 ms,不是地形单项。 | 整场景 GPU CSV P95 1.632 ms;RHI 口径 1.579 ms。 | 进程内存峰值见下;不能当作地形独占量。 |
这次修改,要等多久才稳定
本阶段没有按编辑组统计更新延迟。网格输出有多大
本阶段没有按更新组记录输出数组大小。该值是生成量,包含多个节点,不是同时驻留峰值,也不是 GPU 上传字节或显存占用;Section 副本、碰撞、容量余量和旧资源均另计。
查看此阶段的 GPU 绘制开销
图中不是完整 GPU 分解。GPU Pass 可能跨队列重叠,各自 P95 不可累加;这里也没有把整场景 BasePass 误写成“地形绘制成本”。
0.75 m 小笔刷:有效帧 15,011,接受编辑 85 次,更新组稳定 85 次。两者按各自记录时刻归档,跨阶段完成的组可能使数量不同。下图分别统计真实发生工作的样本,不用空闲帧稀释开销。
条长以 8.333 ms 为参照。四条的统计单位不同,不能相加;安装软预算 0.35 ms 是限流参数,不是耗时保证。
逐步查看 CPU、GPU 和内存归属
| 步骤 | CPU 计时与范围 | GPU 工作 | 内存 / 显存 |
|---|---|---|---|
| 01 命中与笔刷定位 | 未单独测量;本轮使用固定中心直接编辑。 | CPU 查询;无独立地形计算 Pass。 | 未做该步骤分配追踪。 |
| 02 修改数据与更新父层 | 0.241 ms / 笔 | CPU 执行;不向 GPU 写整个体素世界。 | 本轮对齐编辑数组:8.00 KiB;压缩节点、COW 和容器开销另计。 |
| 03 失效、LOD 与排队 | 与地形 Tick、安装及发布存在包含关系;未独立隔离。 | CPU 调度;后续渲染更新另计。 | 节点状态、通知、在途快照;独立增量未测。 |
| 04 读取 / 过滤 / 网格 / 打包 | 3.958 ms / 最长任务 | 本地图走 CPU 网格生成;没有对应 GPU 计算 Pass。 | 单个 Level 6 任务固定数组约 632.94 KiB;几何输出另加。 |
| 05 UE Section 预整理 | 位于后台 PrepareUploadMesh;不在 MeshNode 计时内,未单测。 | CPU 建立上传结构;GPU 资源随后创建。 | 还会建立 FProcMeshSection 顶点 / 索引副本,未独立采样。 |
| 06 安装与碰撞提交 | 0.200 ms / 活动帧 | GPU 资源创建与传输未独立计时;不能记为 0。 | 旧资源、新 Section 和在途渲染资源可能同时存在。 |
| 07 Chaos 碰撞烹饪 | 异步执行;独立 CPU 工作时间尚未测量。 | 该路径为 CPU 碰撞;不使用 GPU 流体或粒子碰撞。 | 三角形碰撞与加速结构尚未单独归属。 |
| 08 节点发布与旧资源回收 | 0.124 ms / 活动帧 | 渲染状态切换 / 延迟释放未独立归属。 | 共享引用与旧资源释放时机决定峰值;本轮未分配追踪。 |
| 09 持续显示新地形 | 整场景 Game Thread P95 1.343 ms,不是地形单项。 | 整场景 GPU CSV P95 1.589 ms;RHI 口径 1.576 ms。 | 进程内存峰值见下;不能当作地形独占量。 |
这次修改,要等多久才稳定
以上均为 P95。第一项是整段延迟;第二项把并行任务累加,不能当成单帧卡顿;第三项还包含帧对齐、调度和碰撞就绪等待,不是 Chaos 的 CPU 耗时。
网格输出有多大
该阶段每更新组生成的 CPU 数组内容 P95 为 2.375 MiB。该值是生成量,包含多个节点,不是同时驻留峰值,也不是 GPU 上传字节或显存占用;Section 副本、碰撞、容量余量和旧资源均另计。
查看此阶段的 GPU 绘制开销
图中不是完整 GPU 分解。GPU Pass 可能跨队列重叠,各自 P95 不可累加;这里也没有把整场景 BasePass 误写成“地形绘制成本”。
2.50 m 大笔刷:有效帧 14,566,接受编辑 239 次,更新组稳定 240 次。两者按各自记录时刻归档,跨阶段完成的组可能使数量不同。下图分别统计真实发生工作的样本,不用空闲帧稀释开销。
条长以 8.333 ms 为参照。四条的统计单位不同,不能相加;安装软预算 0.35 ms 是限流参数,不是耗时保证。
逐步查看 CPU、GPU 和内存归属
| 步骤 | CPU 计时与范围 | GPU 工作 | 内存 / 显存 |
|---|---|---|---|
| 01 命中与笔刷定位 | 未单独测量;本轮使用固定中心直接编辑。 | CPU 查询;无独立地形计算 Pass。 | 未做该步骤分配追踪。 |
| 02 修改数据与更新父层 | 0.495 ms / 笔 | CPU 执行;不向 GPU 写整个体素世界。 | 本轮对齐编辑数组:64.00 KiB;压缩节点、COW 和容器开销另计。 |
| 03 失效、LOD 与排队 | 与地形 Tick、安装及发布存在包含关系;未独立隔离。 | CPU 调度;后续渲染更新另计。 | 节点状态、通知、在途快照;独立增量未测。 |
| 04 读取 / 过滤 / 网格 / 打包 | 4.486 ms / 最长任务 | 本地图走 CPU 网格生成;没有对应 GPU 计算 Pass。 | 单个 Level 6 任务固定数组约 632.94 KiB;几何输出另加。 |
| 05 UE Section 预整理 | 位于后台 PrepareUploadMesh;不在 MeshNode 计时内,未单测。 | CPU 建立上传结构;GPU 资源随后创建。 | 还会建立 FProcMeshSection 顶点 / 索引副本,未独立采样。 |
| 06 安装与碰撞提交 | 0.213 ms / 活动帧 | GPU 资源创建与传输未独立计时;不能记为 0。 | 旧资源、新 Section 和在途渲染资源可能同时存在。 |
| 07 Chaos 碰撞烹饪 | 异步执行;独立 CPU 工作时间尚未测量。 | 该路径为 CPU 碰撞;不使用 GPU 流体或粒子碰撞。 | 三角形碰撞与加速结构尚未单独归属。 |
| 08 节点发布与旧资源回收 | 0.158 ms / 活动帧 | 渲染状态切换 / 延迟释放未独立归属。 | 共享引用与旧资源释放时机决定峰值;本轮未分配追踪。 |
| 09 持续显示新地形 | 整场景 Game Thread P95 1.583 ms,不是地形单项。 | 整场景 GPU CSV P95 1.577 ms;RHI 口径 1.566 ms。 | 进程内存峰值见下;不能当作地形独占量。 |
这次修改,要等多久才稳定
以上均为 P95。第一项是整段延迟;第二项把并行任务累加,不能当成单帧卡顿;第三项还包含帧对齐、调度和碰撞就绪等待,不是 Chaos 的 CPU 耗时。
网格输出有多大
该阶段每更新组生成的 CPU 数组内容 P95 为 3.538 MiB。该值是生成量,包含多个节点,不是同时驻留峰值,也不是 GPU 上传字节或显存占用;Section 副本、碰撞、容量余量和旧资源均另计。
查看此阶段的 GPU 绘制开销
图中不是完整 GPU 分解。GPU Pass 可能跨队列重叠,各自 P95 不可累加;这里也没有把整场景 BasePass 误写成“地形绘制成本”。
移动相机:有效帧 14,702,接受编辑 0 次,更新组稳定 0 次。两者按各自记录时刻归档,跨阶段完成的组可能使数量不同。下图分别统计真实发生工作的样本,不用空闲帧稀释开销。
条长以 8.333 ms 为参照。四条的统计单位不同,不能相加;安装软预算 0.35 ms 是限流参数,不是耗时保证。
逐步查看 CPU、GPU 和内存归属
| 步骤 | CPU 计时与范围 | GPU 工作 | 内存 / 显存 |
|---|---|---|---|
| 01 命中与笔刷定位 | 未单独测量;本轮使用固定中心直接编辑。 | CPU 查询;无独立地形计算 Pass。 | 未做该步骤分配追踪。 |
| 02 修改数据与更新父层 | 本阶段没有编辑。 | CPU 执行;不向 GPU 写整个体素世界。 | 本轮对齐编辑数组:—;压缩节点、COW 和容器开销另计。 |
| 03 失效、LOD 与排队 | 与地形 Tick、安装及发布存在包含关系;未独立隔离。 | CPU 调度;后续渲染更新另计。 | 节点状态、通知、在途快照;独立增量未测。 |
| 04 读取 / 过滤 / 网格 / 打包 | 没有按编辑组记录任务耗时。 | 本地图走 CPU 网格生成;没有对应 GPU 计算 Pass。 | 单个 Level 6 任务固定数组约 632.94 KiB;几何输出另加。 |
| 05 UE Section 预整理 | 位于后台 PrepareUploadMesh;不在 MeshNode 计时内,未单测。 | CPU 建立上传结构;GPU 资源随后创建。 | 还会建立 FProcMeshSection 顶点 / 索引副本,未独立采样。 |
| 06 安装与碰撞提交 | 0.141 ms / 活动帧 | GPU 资源创建与传输未独立计时;不能记为 0。 | 旧资源、新 Section 和在途渲染资源可能同时存在。 |
| 07 Chaos 碰撞烹饪 | 异步执行;独立 CPU 工作时间尚未测量。 | 该路径为 CPU 碰撞;不使用 GPU 流体或粒子碰撞。 | 三角形碰撞与加速结构尚未单独归属。 |
| 08 节点发布与旧资源回收 | 0.004 ms / 活动帧 | 渲染状态切换 / 延迟释放未独立归属。 | 共享引用与旧资源释放时机决定峰值;本轮未分配追踪。 |
| 09 持续显示新地形 | 整场景 Game Thread P95 1.498 ms,不是地形单项。 | 整场景 GPU CSV P95 1.722 ms;RHI 口径 1.669 ms。 | 进程内存峰值见下;不能当作地形独占量。 |
这次修改,要等多久才稳定
本阶段没有按编辑组统计更新延迟。网格输出有多大
本阶段没有按更新组记录输出数组大小。该值是生成量,包含多个节点,不是同时驻留峰值,也不是 GPU 上传字节或显存占用;Section 副本、碰撞、容量余量和旧资源均另计。
查看此阶段的 GPU 绘制开销
图中不是完整 GPU 分解。GPU Pass 可能跨队列重叠,各自 P95 不可累加;这里也没有把整场景 BasePass 误写成“地形绘制成本”。
能否留出 120 Hz 的空间
本轮离屏采样的 P99 均低于 8.333 ms。120 Hz 每帧约 8.333 ms;当前为整款游戏预留的目标是主线程 6.0 ms、GPU 7.0 ms。CPU 和 GPU 有流水并行关系,不能把二者相加计算帧时间。单轮基础地图通过某个数值,也不能替代完整玩法验收。
| 测试阶段 | 整帧 P95 / P99 | 主线程 P95 | GPU CSV / RHI P95 | 超过 8.333 ms 的帧 |
|---|---|---|---|---|
| 静止观察 | 2.404 / 2.649 ms | 1.241 ms | 1.632 / 1.579 ms | 0 / 15,105 |
| 0.75 m 小笔刷 | 2.411 / 2.656 ms | 1.343 ms | 1.589 / 1.576 ms | 1 / 15,011 |
| 2.50 m 大笔刷 | 2.492 / 2.755 ms | 1.583 ms | 1.577 / 1.566 ms | 0 / 14,566 |
| 移动相机 | 2.449 / 2.697 ms | 1.498 ms | 1.722 / 1.669 ms | 1 / 14,702 |
分项仍有约束:编辑、LOD 与调度共分配 0.45 ms,大笔刷仅数据修改的 P95 就有 0.495 ms,已经超过这份配额。安装与发布按活动帧合计,小 / 大笔刷 P95 为 0.259 ms / 0.338 ms,本轮低于 0.50 ms 配额。它们是两组统计,不能拿各自 P95 再相加推算最坏帧。
内存要分成“整个进程”和“单个任务”看
| 资源 | 本轮结果 / 计算容量 | 含义 |
|---|---|---|
| 整个 UE 进程 · 工作集峰值 | 2.549 GiB | 低频采样,包含启动、引擎、地图和测试记录。 |
| 整个 UE 进程 · 私有提交峰值 | 2.951 GiB | 虚拟提交;与工作集重叠,二者不能相加。 |
| 该 UE 进程 · 专用显存峰值 | 476.738 MiB | WDDM 进程采样;包含场景、纹理、渲染目标及引擎资源。 |
| 8³ 个 16 位样本 | 1.00 KiB | 未压缩的内容大小;压缩节点与对象实际开销不同。 |
| 0.75 m / 2.50 m 编辑缓冲 | 8.00 KiB / 64.00 KiB | 按本轮固定中心与对齐算法计算;不是测到的分配峰值。 |
| 压缩节点内容 · 测试结束 | 1.419 MiB | 含撤销历史中共享节点的去重 payload;不含容器、公共基底和引擎对象。 |
| 网格 / Chaos / 地形专用显存 | 尚未独立归属 | 不按整个 UE 进程的内存反推地形占用。 |
展开单个网格任务的内存计算
| 单个 Level 6 任务 | 数组内容 | 容量 |
|---|---|---|
| 四层原始读取 | (40³ + 14³ + 10³ + 8³) × 2 B | 133.31 KiB |
| 预处理样本 | 40³ × 2 B | 125.00 KiB |
| 过滤后的密度 | 36³ × 4 B | 182.25 KiB |
| 过滤临时整数和 | 36 × 36 × 38 × 4 B | 192.38 KiB |
| 辅助场 | 40³ × 1 B | 62.50 KiB |
| 网格单元索引缓存 | 36³ × 2 B | 91.12 KiB |
过滤时,上表前四项同时存在,逻辑内容合计 632.94 KiB;进入网格阶段后,过滤临时数组释放,辅助场与索引缓存生效,固定内容合计 594.19 KiB。顶点、四边形、簇、打包输出和 UE 副本另加,不能将这些固定数组当作任务总内存。
若 16 个 Level 6 任务同时处在过滤阶段,仅这部分固定数组为 9.890 MiB。这是容量计算,不是实测峰值或总内存上限。CPU 中间顶点为 52 B / 顶点,原格式打包为 12 B / 顶点;UE 解码、Section、渲染缓冲与碰撞会各自占用内存,不能用 12 B 估算整条链。
下一轮需要补齐独立的读取、过滤、预整理和 Chaos 工作计时,以及分阶段分配追踪与地形 GPU 隔离。当前表格不会将这些缺失项记为零,也不会用安装后的等待时间代替碰撞耗时。
进阶参考:数据结构、表面算法与 UE 调度
前面的五步说明因果关系。以下 13 节保留代码层面的精确定义、工程参数、二维交互和已有验证记录;需要深入实现时可按主题查阅。
系统分层与数据依赖
地形密度是可编辑的权威数据。可见网格和碰撞由密度派生;水体保留独立状态,通过变化通知更新地形障碍。
- 输入
- 相同世界坐标、密度快照和变化版本
- 处理
- 各系统独立生成与调度
- 输出
- 网格、碰撞及水体障碍分别更新
实现边界 烟雾尚未接入。后续可消费相同变化通知,但模拟状态、求解网格和时间步需要独立设计。
采样编码与层级组织
自然地形使用 16 位采样字,保存材料类别与固体占据量。存储样本与表面三角形属于不同层次的数据。
高 8 位 · 占据量
低 8 位 · 材料类别
- 最细采样间距
- 25 cm
- 最细层逻辑容量
- 256³ 个样本
- 完全铺开该层
- 32 MiB
实现边界 32 MiB 仅为最细逻辑层的 16 位数据量,不包含父层、快照、网格、碰撞与分配开销。材料类别 ≥128 的建筑几何有独立解释规则。
不可变快照与写时复制
后台网格任务读取固定快照。编辑产生新世界状态,未修改节点继续共享,受影响节点在写入时复制。
- 输入
- Vₙ 快照与修改范围
- 处理
- 复制待写节点、补齐父层、递增版本
- 输出
- 世界切换到 Vₙ₊₁;旧任务继续读取 Vₙ
实现边界 任务完成后仍需检查版本有效性。快照隔离保证读取一致,不意味着过时网格可以发布。
初始地形的构形与量化
生成器先构造山坡和洞穴的三维标量场,再量化为占据量。运行时编辑修改量化后的数据,不重新生成整座山体。
- 输入
- 高斯轮廓、Perlin 噪声、岩台、胶囊通道及椭球洞室
- 处理
- 高度扩展为三维场 → min 合并 → max 相减 → 量化
- 输出
- 材料 86 的占据量样本;更新父层并保存基底缓存
实现边界 负值表示固体、正值表示空气。组合形式接近 SDF,但叠加高度与噪声后不再处处是精确距离。修改公式时须同步更新 SourceVersion。
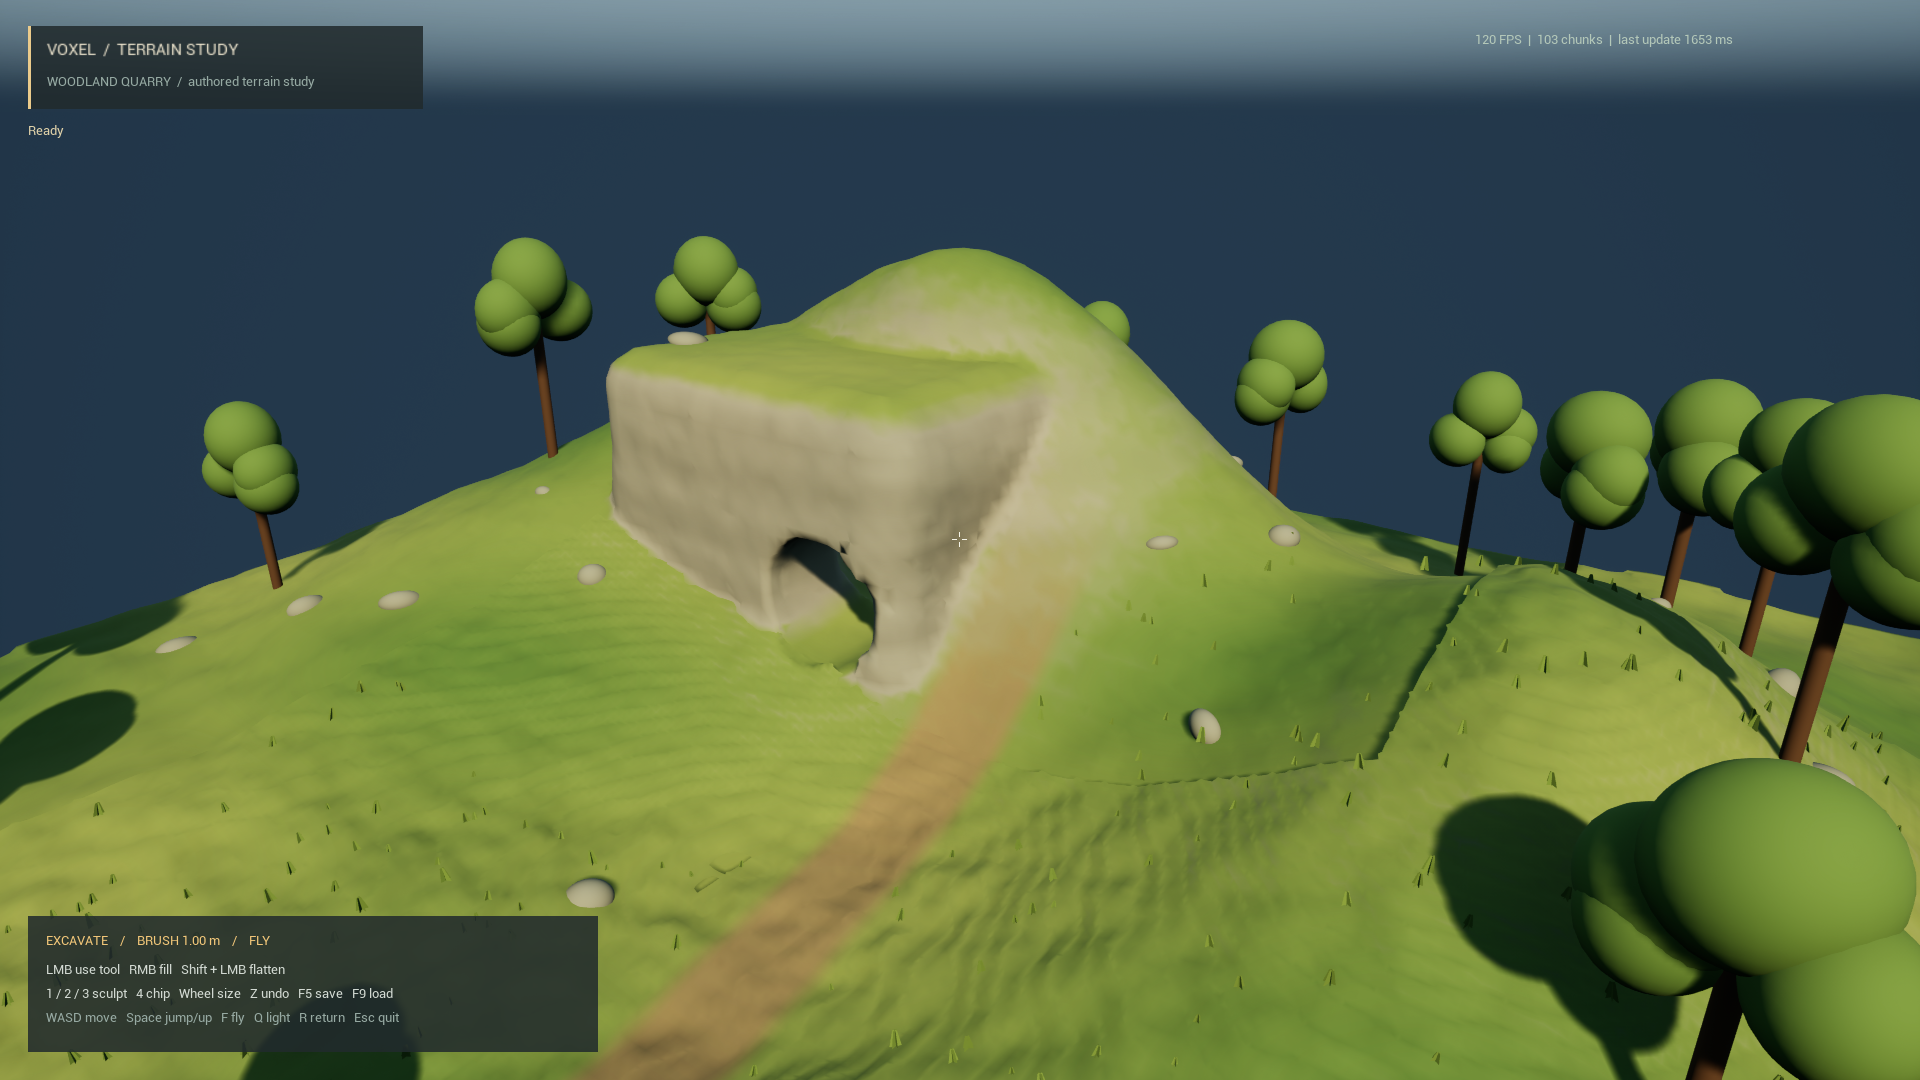
局部编辑范围与材料工作量
一次编辑先确定笔刷作用域,再准备对齐的立方体缓冲。Remove 内核按距离分组,从中心向外消耗本次工作量。
- 输入 Low / High
- (11,18,9) / (21,26,14)
- 缓冲 Minimum
- (8,16,8)
- 缓冲 Size
- 16 × 16 × 16
- 输入
- 18 m 射线命中、法线、0.5~2.5 m 半径
- 处理
- 挖掘中心内移 0.3R → 对齐读取 → 距离分组扣量 → 清理 → 写回
- 输出
- 修改后的局部采样、父层与变化通知
实现边界 普通连续操作间隔为 0.12 秒。0.0005 是当前工程手感参数,不是已确认的原作材料值。填土使用 Add;整平使用水平 Flatten。孤立样本清理不等于刚体坍塌。
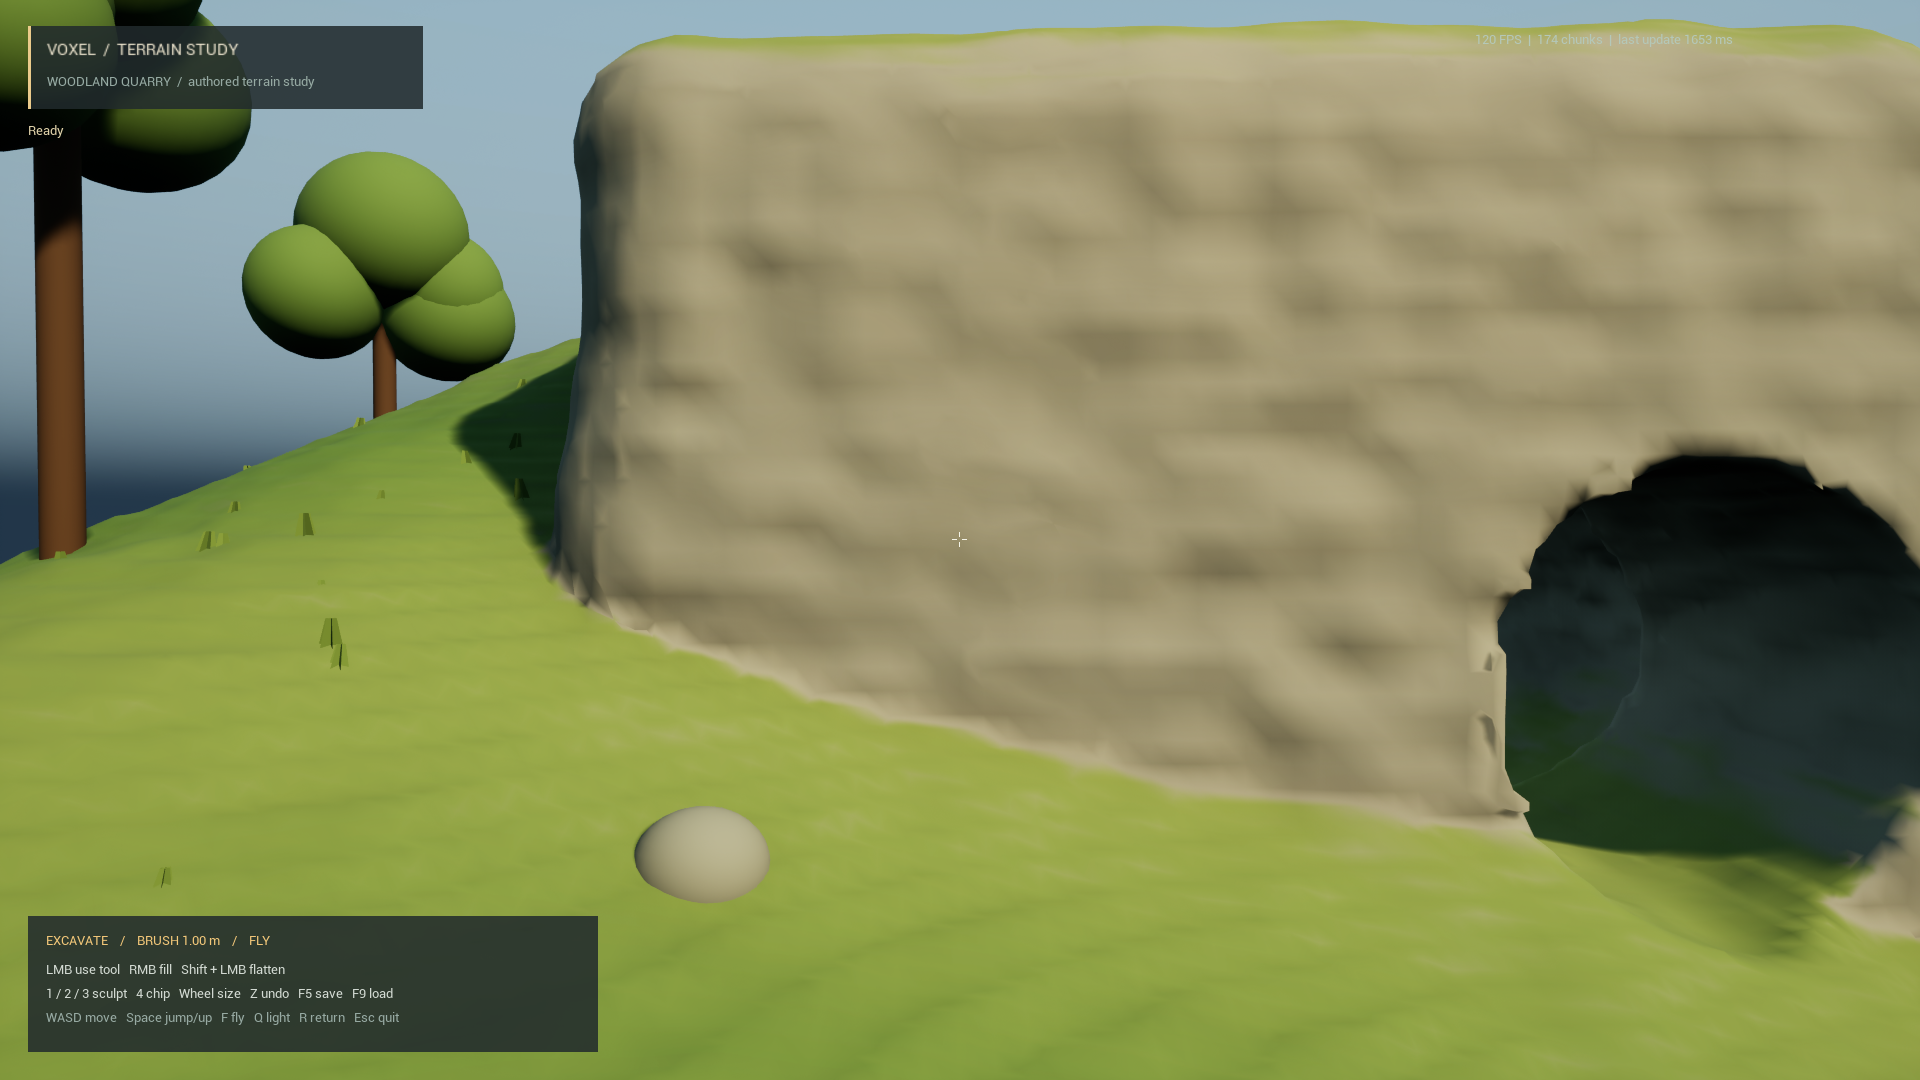
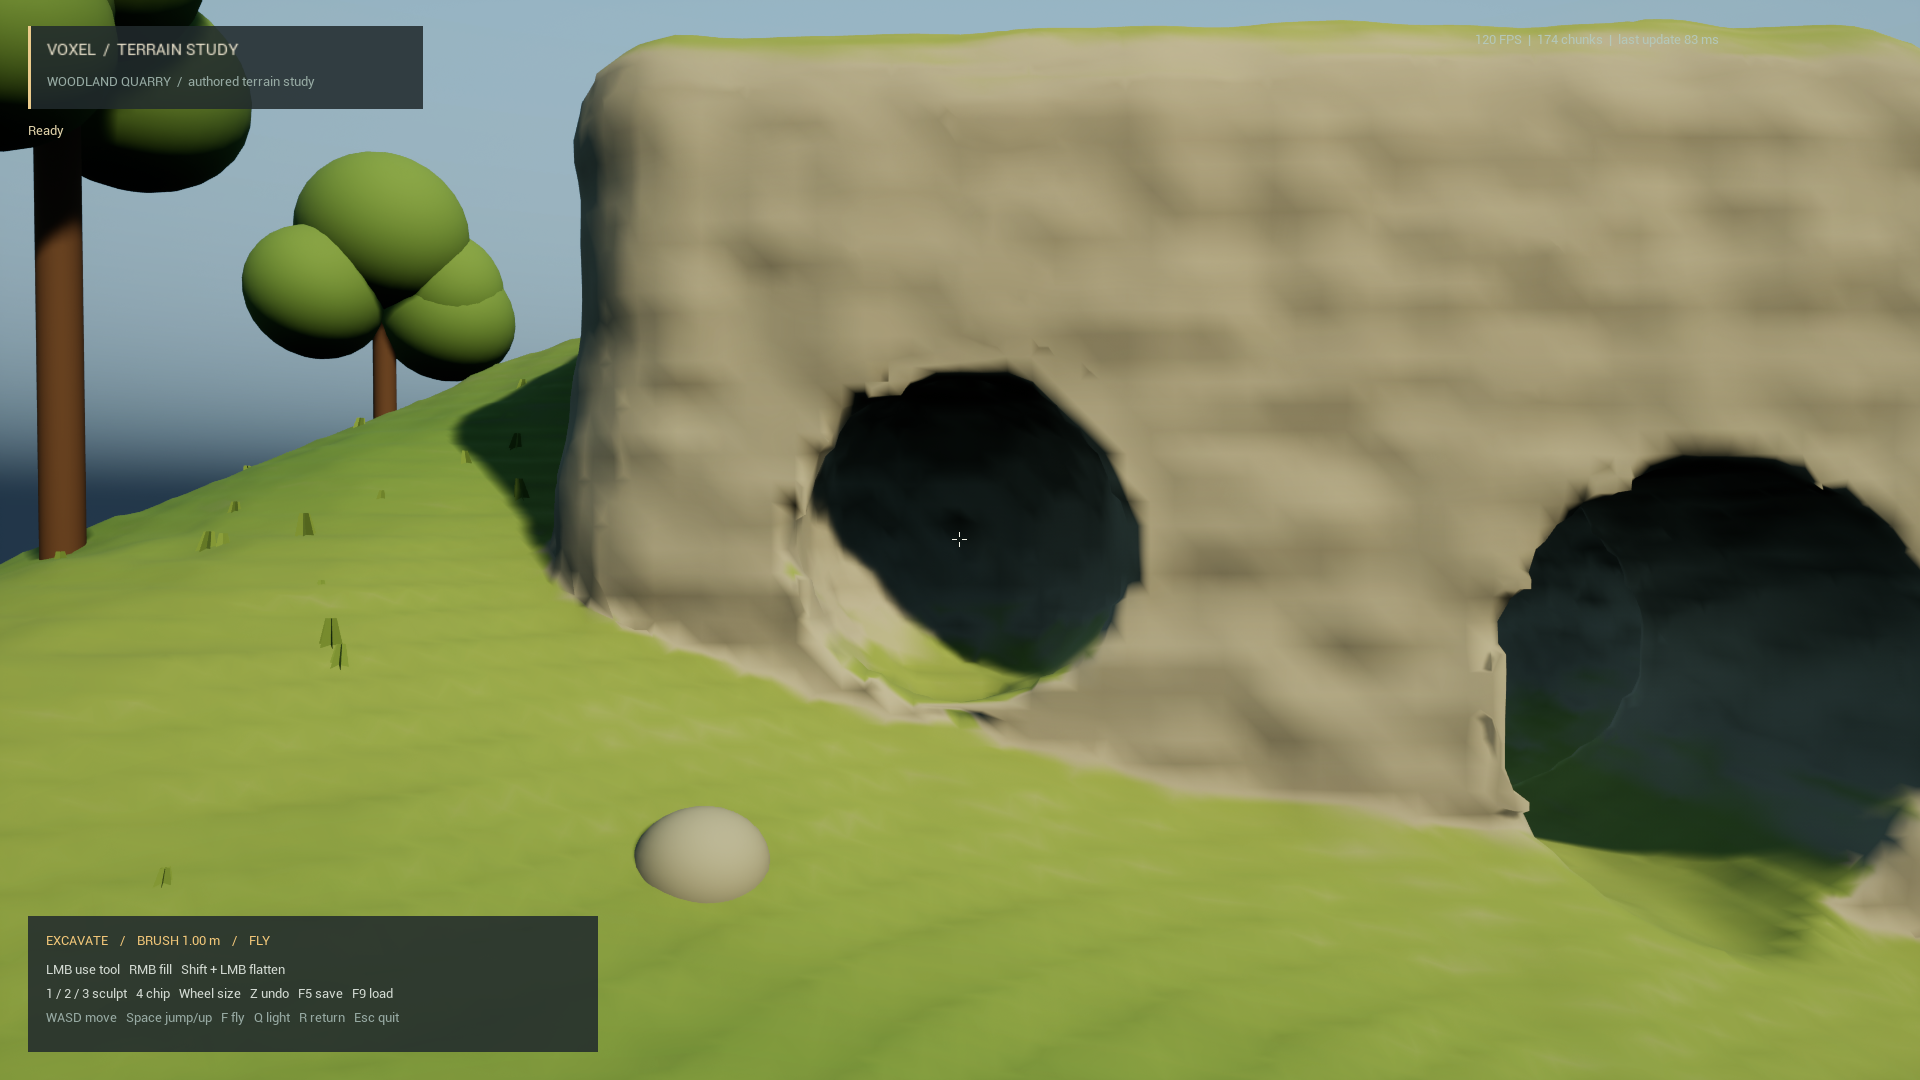
单元交点与表面顶点
自然地形采用 Surface Nets 风格的单元顶点方法。边穿过零值时产生交点,交点均值给出该单元的代表顶点。
- 01读取与过滤自定义 3³ 邻域过滤
- 02边交点插值在异号角点之间线性插值
- 03单元代表顶点平均全部有效交点
- 04连接表面相邻单元连接四边形,再拆为三角形
实现边界 过滤组合中心值、邻域均值和极值,不是简单的 27 点平均;顶点求解未采用 QEF。法线由密度变化估计。
邻域窗口与多层网格
网格任务不能只读取核心区域。密度过滤、法线与边界处理需要邻域数据;LOD 改变采样尺度及覆盖范围。
- 输入
- 相机选择的节点与固定快照
- 处理
- 四次源读取 → 密度窗口过滤 → 核心表面生成
- 输出
- MeshNode 接受 Level 4~6;最细核心边长约 8 m
实现边界 最高布局四次读取涉及 Level 6、4、3、2。边界顶点沿法线收缩,但混合 LOD 接缝尚未彻底解决;当前扩大近景细节范围以缓解。
异步任务与发布状态
数据、网格和碰撞可以处于不同版本。新资源完成前保留旧节点;版本有效且碰撞就绪后,按节点切换可见资源。
- 后台网格任务上限
- 16 个
- 主线程安装限流
- 0.35 ms 软预算
- 单帧安装次数
- 最多 2 次
- 空闲组件保留目标
- 最多 32 个
- 输入
- 带范围与版本的变化通知
- 处理
- 快照读取 → Section 预整理 → 组件复用 → 异步 Chaos 烹饪
- 输出
- 版本检查后发布;过时结果丢弃并重新排队
实现边界 软预算在下一次安装开始前检查,单次安装不能抢占,仍可能超时。0.35 ms 不是实测总耗时。节点并非同时原子切换,烹饪中组件可能使池规模暂时超过保留目标。
完整编辑链交互验证
剖面将密度修改、网格准备、碰撞就绪与发布分开,用于检查“数据已改变、旧表面仍保留”的中间状态。
- 输入
- 点击剖面定位,或展开键盘定位控件
- 处理
- 执行挖掘 / 填土,逐步推进更新
- 输出
- 对照采样点、待发布边界与已发布表面
实现边界 该图使用简化的二维占据量编辑,不执行三维材料工作量内核。点数、手动步进时间和撤销速度不能用于估算 UE 性能。
地形变化与水体障碍更新
水体保存独立的分层水柱与体积状态。地形提供脏范围和新版本,水体在地形稳定后重采样受影响的障碍。
- 输入
- 相同坐标、TerrainDensityRevision 与变化范围
- 处理
- 地形忙时沿用旧障碍;稳定后重采样相关水柱
- 输出
- 新的可通行关系参与后续水流求解
实现边界 持续编辑可能推迟障碍刷新。土塞是真实密度几何,不是隐藏脚本开关;当前实现不等同于 Fluid Flux 或 FluidNinja。
快照撤销与 VDR2 存档
撤销回到已有地形快照,存档持久化压缩后的完整地形状态。两者均不以可见三角形作为主要状态来源。
VDR · v2- 01写入临时文件完整状态及校验信息
- 02完成写入保留原目标文件
- 03替换目标将临时文件移动为正式存档
实现边界 当前 Undo 使全部网格失效,取回快照后的重建成本不能省略。F5 / F9 与 Undo 只处理地形,不保存或回退水状态。不同地图使用独立 profile;基底缓存与玩家存档分离。
预算参数与验证证据
参数约束、功能通过和性能达标属于不同证据。下图标明结论的适用范围,避免将配置值作为实测开销。
- 01数据与生成减负高度复用、空块跳过、基底缓存、节点共享
- 02局部与后台处理局部编辑、相机 LOD、异步过滤及网格准备
- 03主线程发布减负组件复用、分帧安装、异步碰撞、过时任务淘汰
实现边界 动态地形为 CPU 网格生成,不是 Nanite 地形。Lumen、正式植被、烟雾、角色和完整物理负载尚未同时验收,功能验证不能证明完整游戏达到 120 Hz。
模块职责与源码索引
模块按数据流拆分。每组文件对应明确职责,参数及文件校验值可在公开快照中核对。
TerrainStudy.cpp · TerrainStudyWorld.cppHeight / Density / CreateStudy;构形、量化与基底缓存。
DigGame.cpp · DigTerrain.cpp · VoxelOriginalWorld.cpp射线、工具、快照、版本与存档。
OriginalTerrainRegion.h · OriginalTerrainEdit.h局部缓冲与 Remove / Add / Flatten。
OriginalTerrainWorker.h · OriginalTerrainKernels.h邻域读取、DensityGrid、Cell 与 FullCell。
DigOriginalScheduler.cpp · DigMeshComponent.cpp任务、Section 预整理、组件池与 Chaos 烹饪。
WaterStudy.cpp密度版本、变化范围及水柱障碍重采样。
实现边界 本文仅陈述现行代码与已有记录可确认的行为。工程含逆向后对齐的部分内核,也含独立实现的地图、材质、UE 接入与水流,不据此宣称完整复现原作算法或性能。